AgentFlow:把几十个 AI 编程 agent 编排成一张可并行、可迭代的图
posts posts 2026-04-01T01:09:00+08:00用 DAG + 管道符把 codex、claude、kimi、pi 等编程 agent 编排成依赖图,支持并行扇出、迭代循环、Docker/SSH/EC2/ECS 执行与模型路由。技术笔记Claude, Codex, Kimi, agent, 编排AgentFlow:把几十个 AI 编程 agent 编排成一张可并行、可迭代的图
真正难的不是让一个 agent 干活,而是让几十个 agent 按依赖关系同时开工、失败了自己重来、结果最后汇总成一份。AgentFlow 解决的是后一个问题:它把"调度并发、处理重试、归并结果"这些手写脚本才做的事,收进一张用 >> 连起来的依赖图里。
这个项目由 agentenv 组织维护,配套论文《Synthesizing Multi-Agent Harnesses for Vulnerability Discovery》(Yu Feng 团队,arXiv:2604.20801,2026-04-22 发布)。它把 codex、claude、kimi、pi 等编程 agent 当成图中的节点,用几组原语(fanout、merge、on_failure)表达并行、汇总和循环。下面先给一张系统地图,再逐条拆。
先看这张图
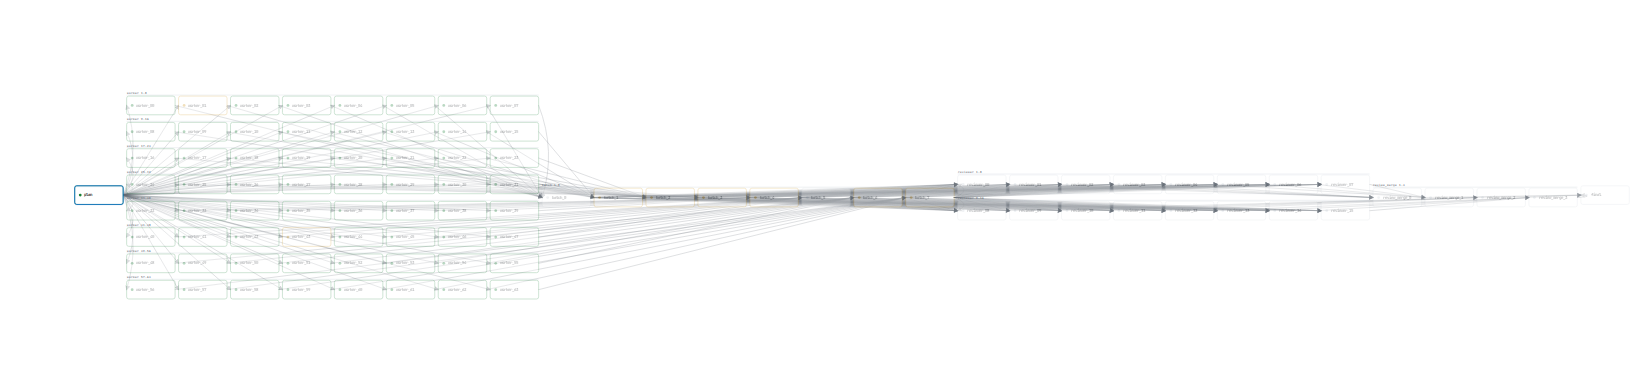
README 里那张 94 节点的示例图,是一条典型的流水线:plan 拆出 64 个 worker,8 个批量归并先收一层,16 个 review 接力,再经 4 个 review merge,最后收敛到 synthesis。它把"一个 agent 从头干到尾"拆成了"一段并行工作 + 几次收敛"。
核心数据(GitHub API 2026-09-23 验证)
| 项目 | 数值 |
|---|---|
| 仓库 | agentenv/agentflow |
| Stars | 1,405 |
| Forks | 290 |
| 语言 | Python |
| 协议 | MIT |
| 默认分支 | master |
| 创建时间 | 2026-03-08 |
| 最近推送 | 2026-09-13 |
配套论文发表在 arXiv(2604.20801,2026-04):AgentFlow 在 TerminalBench-2 上拿到 84.3%(Claude Opus 4.6),对照当时公开榜单是最高分;在 Google Chrome 上发现了 10 个此前未知的零日漏洞(Kimi K2.5),其中 2 个是 Critical 级别的沙箱逃逸(CVE-2026-5280、CVE-2026-6297)。这是它的来头,也是理解它设计动机的钥匙——那篇论文要解决的正是"harness 怎么写才让 agent 找得到漏洞"。
安装与上手
一键安装会装好 agentflow、加入 PATH,并为 Codex 和 Claude Code 各装一个 skill:
curl -fsSL https://raw.githubusercontent.com/agentenv/agentflow/master/install.sh | bash也可以手动装:
python3 -m venv .venv && . .venv/bin/activate
pip install -e .[dev]
装完 skill 之后,甚至不用自己写管道,直接在 Codex 里说一句:“Use agentflow to fan out 10 codex agents, each telling a unique joke, then merge their outputs and pick the funniest one. Write the pipeline and run it.” skill 会自动生成管道文件并执行。想亲手写,看下面的例子。
编排的核心:一张 DAG,几组原语
AgentFlow 用有向无环图(DAG)组织节点。节点之间用 >> 连接,表示"前一个的输出进后一个的输入"。上游输出通过模板语法 {{ nodes.plan.output }} 引用:
from agentflow import Graph, codex, claude

with Graph("my-pipeline", concurrency=3) as g:
    plan = codex(task_id="plan", prompt="Inspect the repo and plan the work.", tools="read_only")
    impl = claude(task_id="impl", prompt="Implement the plan:\n{{ nodes.plan.output }}", tools="read_write")
    review = codex(task_id="review", prompt="Review:\n{{ nodes.impl.output }}")

    plan >> impl >> review

print(g.to_json())
print(g.to_json()) 会把这张图序列化成 JSON——图本身是数据,agentflow inspect 能把它展开给人看,agentflow validate 能只校验不运行。这意味着管道既可以被检查,也可以被另一个 agent 改写(后面会说到优化轮次)。
Graph 的参数不止 concurrency(默认 4):max_iterations 默认 10,fail_fast 控制是否一败即停,use_worktree 让每个节点在一个独立 git worktree 里跑(.agentflow/worktrees/<run_id>/<node_id>),互不踩工作区。
agent 节点不是黑盒。官方的 Agent notes 写明了每个 CLI 的真实接法:Codex 用 codex exec --json,tools 模式映射到沙箱策略;Claude 用 claude -p ... --output-format stream-json --verbose;Kimi 由内置 bridge 转成 JSON-RPC 事件流,底层调 Moonshot 的 OpenAI 兼容 API。
框架提供的节点函数不多,真正的工作都压在这几组原语上:
| 原语 | 作用 |
|---|---|
codex / claude / kimi / pi | 对应各家的编程 agent 节点 |
agent(name) | 按名字实例化任意后端,tuned agent 也走这里 |
python_node / shell | 不经模型,直接跑一段 Python(python3 -c)或 shell(bash -c) |
sync | 把本地仓库同步到远程 target,优先 rclone,回退 tar + scp |
fanout(node, source) | 把一个节点扇出成多个并行副本 |
merge(node, source, ...) | 把多个副本的结果归约成一个 |
.on_failure | 失败时把控制流送回指定的上游节点 |
success_criteria | 定义"这次算成功"的条件 |
并行:fanout 与 merge
fanout(node, source) 按 source 的类型决定展开方式:
int:生成 N 个相同副本,例如fanout(node, 128)。list:每个元素一个副本,元素通过{{ item.file }}传入。dict:多轴笛卡尔积,例如{"axis1": [...], "axis2": [...]}。
归约用 merge,有批量(size=N)和分组(by=["field"])两种。一个典型的代码审查管道是这样扇出再收敛的:
from agentflow import Graph, codex, fanout, merge

with Graph("code-review", concurrency=8) as g:
    scan = codex(task_id="scan", prompt="List the top 5 files to review.")
    review = fanout(
        codex(task_id="review", prompt="Review {{ item.file }}:\n{{ nodes.scan.output }}"),
        [{"file": "api.py"}, {"file": "auth.py"}, {"file": "db.py"}],
    )
    summary = codex(task_id="summary", prompt=(
        "Merge findings:\n{% for r in fanouts.review.nodes %}{{ r.output }}\n{% endfor %}"
    ))
    scan >> review >> summary

print(g.to_json())
fanouts.review.nodes 是扇出结果的模板入口,{% for %} 是 Jinja2 循环,用它把若干份 review 喂给 summary。这就是"并行出、收敛归"的骨架。
迭代:on_failure 与 success_criteria
并行解决"同时跑很多",迭代解决"跑完要收敛到合格"。on_failure 把失败的控制流送回上游节点,配合 success_criteria 和 max_iterations 形成写→评→改的闭环:
from agentflow import Graph, codex, claude

with Graph("iterative-impl", max_iterations=5) as g:
    write = codex(
        task_id="write",
        prompt="Write a Python email validator.\n{% if nodes.review.output %}Fix: {{ nodes.review.output }}{% endif %}",
        tools="read_write",
    )
    review = claude(
        task_id="review",
        prompt="Review:\n{{ nodes.write.output }}\nIf complete, say LGTM. Otherwise list issues.",
        success_criteria=[{"kind": "output_contains", "value": "LGTM"}],
    )
    write >> review
    review.on_failure >> write  # loop until LGTM or max_iterations

print(g.to_json())
success_criteria 共五种结构化条件:output_contains、output_regex、file_exists、file_contains、file_nonempty。判断"算不算成"比抓关键词明确,也更容易被 validate 检查。
执行目标:从本地到远程
节点默认在本地跑,target 参数可以把执行挪到别的环境。按 kind 字段分,当前有 docker、cloud_hypervisor、ssh、ec2、ecs 五种非本地目标,另保留 legacy 的 container 做兼容。
Docker。 先把包含全部 agent CLI 的镜像构建一次:
docker build -t agentflow-agents:latest .之后 kind: "docker" 就用这个镜像。AgentFlow 会自动把管道工作区 bind-mount 进容器,并为每个节点挂一个可写的运行时目录:
codex(
    task_id="review",
    prompt="Review the repository without changing it.",
    tools="read_only",
    target={
        "kind": "docker",
        "workdir_read_only": True,
        "mounts": [
            {"source": "./docs", "target": "/reference", "read_only": True},
        ],
        "network_policy": "bridge",
    },
)
两个默认值值得知道:容器默认以宿主的 UID:GID 运行(user: "host"),免得 bind-mount 产物变成 root 属主;宿主的 API key 环境变量和 CLI 登录目录默认不进容器,provider key 要写进 node.env/provider.env,Codex 登录文件(~/.codex/config.toml、auth.json)须显式 inherit_credentials: true 才以只读挂载暴露。
network_policy 支持 none / bridge / host / 自定义网络;自定义网络可以接到运维管理的出口代理或防火墙后面做更窄的访问。mount_docker_daemon: true 会把宿主 Docker 守护进程的 socket 挂进容器——这等于把宿主 Docker 的 root 级控制权交给了 agent,README 明确警告不要对不可信的 prompt 开启;dind: true 则是在容器内起一个隔离的守护进程,需要 privileged: true,两者不能同时用。
Cloud Hypervisor(KVM 虚拟机)。 每个节点在一个临时的 KVM 虚拟机里启动,比容器隔离更强:只读根文件系统来自上面那个 all-agent 镜像,用 virtio-fs 共享工作区、vsock 传命令和流式输出,控制面不需要 guest SSH。前置也比 Docker 重:先用仓库自带的 export-rootfs.sh 把镜像导出成 rootfs、下载匹配内核,宿主机还要装 cloud-hypervisor、带 UID/GID 映射的 Rust 版 virtiofsd,并有 /dev/kvm 读写权限:
codex(
    task_id="vm-review",
    prompt="Review the repository in an isolated VM.",
    target={
        "kind": "cloud_hypervisor",
        "kernel": ".agentflow/cloud-hypervisor/vmlinux-x86_64",
        "rootfs": ".agentflow/cloud-hypervisor/rootfs",
        "cpus": 4,
        "memory_mib": 8192,
        "workdir_read_only": True,
        "network_policy": "none",
    },
)
默认策略不建任何网络设备;需要模型/API 访问时用显式 TAP 策略挂一个宿主管的接口,路由、NAT、防火墙仍是宿主责任。host 凭据同样默认不继承,除非显式 inherit_credentials: true。
远程机器:EC2 / ECS / SSH。 target 参数声明目标,不需要先建基础设施:
# EC2(自动发现 AMI、密钥对、VPC)
codex(task_id="remote", prompt="...", target={"kind": "ec2", "region": "us-east-1"})
# ECS Fargate(自动发现 VPC,构建 agent 镜像)
codex(task_id="remote", prompt="...", target={"kind": "ecs", "region": "us-east-1"})
# SSH
codex(task_id="remote", prompt="...", target={"kind": "ssh", "host": "server", "username": "deploy"})
多个节点要落在同一台机器上、共享文件,用 shared 参数点名同一个实例:
plan = codex(task_id="plan", prompt="...", target={"kind": "ec2", "shared": "dev-box"})
impl = codex(task_id="impl", prompt="...", target={"kind": "ec2", "shared": "dev-box"})
plan >> impl  # 同一 EC2 实例,文件在两步之间保留
模型路由:用 pi 接任意 provider
除了自家 agent,AgentFlow 还能通过 pi 这个 agent 当目标节点。pi 把 API 调用路由到 Anthropic、OpenAI、Groq、Cerebras、xAI、DeepSeek、Gemini、OpenRouter、Bedrock 等云端 provider,也能通过 OpenAI 兼容或 Anthropic 兼容的协议接本地端点(LMStudio、Ollama):
from agentflow import Graph, codex, pi

with Graph("mixed") as g:
    # 外部模型:Claude 走 Pi
    review = pi(
        task_id="review",
        prompt="Review {{ nodes.impl.output }}",
        model="anthropic/claude-sonnet-4-6:high",
    )
    # 本地模型:先在 ~/.pi/agent/models.json 注册一次 provider
    scan = pi(
        task_id="scan",
        prompt="Scan the repo for TODOs.",
        model="lmstudio/qwen/qwen3.6-27b",
        tools="read_only",
    )
临时用一次的 provider 不必写进 models.json,直接传一个完整的 ProviderConfig:
scan = pi(
    task_id="scan",
    prompt="Scan the repo.",
    provider={
        "name": "local-ollama",
        "base_url": "http://host:11434/v1",
        "wire_api": "openai-completions",
    },
)
ProviderConfig 的字段固定为 name、base_url、api_key_env、wire_api、headers、env——密钥走环境变量名引用而不是明文,schema 禁止多余字段。AgentFlow 会在本次运行里生成一份作用域受限的 models.json(参考 examples/pi_local_lmstudio.py)。这解决了"图里混跑不同模型"的问题:规划的节点走贵的强模型,机械扫描的节点走便宜的本地模型,同一张图里各取所需。
推理与进化:把图当训练数据
AgentFlow 还有两块直接把图变成系统能力的功能。
云端推理。 agentflow inference 能在 SkyPilot 支持的云上起一个 vLLM 或 SGLang 的 OpenAI 兼容端点:
agentflow inference Qwen/Qwen2.5-0.5B-Instruct \
  --gpu aws:1xl4@us-east-1
命令跑完会打印 base_url 和 api_key,外加一份可直接粘贴的 provider 配置,自己传给图里的 pi 节点即可。默认开 spot,关掉用 --no-spot;批量跑 JSONL 任务用 --mode batch。
更省事的写法是在 Graph 上声明 inference=InferenceSetup(...):AgentFlow 会在调度任何节点之前起一个共享的 SkyPilot 服务,再把解析出的 provider 自动注入没有显式设 provider 的 pi 节点:
from agentflow import Graph, InferenceSetup, pi

with Graph(
    "my-pipeline",
    concurrency=3,
    inference=InferenceSetup(
        gpu="aws:8x8xb200@us-east-2",
        model="Qwen/Qwen2.5-0.5B-Instruct",
        engine="sglang",
    ),
) as g:
    pi(task_id="answer", prompt="Use the shared inference service.")
GPU 选择器是"节点数×卡数"的两段式写法:aws:8xb200@us-east-1 是一个节点挂 8 张 B200,aws:8x8xb200@us-east-2 是 8 个节点各挂 8 张。在 AWS B200 上,AgentFlow 会从 AWS SSM 解析当前支持 Blackwell 的 DLAMI,除非你显式传 --image-id。
Tuned Agent 进化。 用一次跑通的 Codex 记录当训练数据,生成一个可复用的 tuned agent:
from agentflow import Graph, codex, evolve

with Graph("improve-codex", working_dir=".") as g:
    source = codex(task_id="plan", prompt="Inspect this repo and summarize the main risks.")
    tuned = evolve(source, target="codex", optimizer="codex")

print(g.to_json())
跑完后 agentflow evolve <run_id> -n <node_id> --target codex --optimizer codex 离线提炼,agentflow tuned-agents 列出已注册的 tuned agent。它们存在 .agentflow/tuned_agents/<name>/versions/<version>/ 下,带完整的 trace、克隆的仓库和版本元数据。默认的 Codex profile 会克隆 openai/codex、让 optimizer 在克隆里改,再用 cargo build 和一串 cargo test 验证——本机要有 Rust 工具链,源运行的 working_dir 也必须同时含 agent_tuner/ 和 .agentflow/。目前 tuned agent 只能解析到本地 target。
另外 Graph 还支持 optimizer 和 n_run,让 optimizer 在两轮之间改写图结构,每轮的产物和日志存在 .agentflow/runs/<run_id>/optimization/round-XXX/ 下。注意 README 明确说:validate 只检查改完的管道能加载、能过 schema 校验,不代表改得语义更好。
Scratchboard:跨 agent 共享的便签
扇出出来的节点彼此独立,想让他们共享同一条上下文怎么办?scratchboard=True 会在所有 agent 之间共享同一个文件,每个 agent 都能读别人的、也往里写自己的。本地节点直接读写 run 目录里的这个文件;远程节点由编排器在执行前后上传、下载,合并时按行去重追加。适合"一堆 agent 共同维护一份候选清单"的场景:
from agentflow import Graph, codex, fanout

with Graph("campaign", scratchboard=True) as g:
    shards = fanout(codex(task_id="fuzz", prompt="..."), 128)
类型化 Actor 与 Agent Profile:九月的新方向
2026-09-13 的提交(#43)给项目加了三层新东西,方向是把"写管道"往"写组件"推。
ActorNode。 继承 ActorNode[Input, Output] 声明一个带类型的角色:输入输出用 Pydantic 模型约束,子类声明 actor_id、actor_version、instructions(inputs)、requirements()、output_artifacts(inputs)。绑定到图上时,每个节点记录类型化输入与 schema、输出契约、actor 版本、能力、bundle 摘要和 profile 摘要;指令内容物化成不可变 bundle,带 SHA-256 指纹。它不引入第二个调度器,只是给现有节点加类型层。
AgentProfile。 把模型、provider、MCP 声明、skills、扩展、secret 引用和超时从工作流配置里拆出来独立管理。profile 不能被节点上的额外绑定选项覆盖,要换后端设置就显式解析一个新 profile;node_options() 在资源预检阶段校验请求的能力组合,后端不支持直接报错。
Harbor Terminus 2 backend。 新增 terminus 这个 agent 后端,适配 Harbor 框架(0.23.0,Python 3.12+)的 Terminus 2 agent:一个独立 controller 被拷进执行容器,把 Harbor 的 BaseEnvironment 桥接到容器内的本地子进程和文件,模型凭据走进程环境变量,原生 trajectory 写进挂载的运行时目录。
配套的还有秘密文件机制:SecretRef(path="/run/secrets/provider") 挂在 secret_env 下,密钥的获取、注入、挂载校验和清理由调用方负责,准备阶段从不读宿主环境变量或家目录——对这类 Docker 适配器,inherit_credentials=True 会被直接拒绝。
本地 Web UI 与 CLI
agentflow serve 在 127.0.0.1:8000 起一个本地 Web UI 和 API,可以在浏览器里看管道状态。安全设计值得注意:/api/runs 和 /api/runs/validate 这两个端点只接受 application/json,且默认禁用了 pipeline_path 参数——浏览器面对的控制面不能仅凭引用一个路径就去执行本地的 .py 管道文件。确实要在可信环境里从文件系统路径加载管道,需要显式 AGENTFLOW_API_ALLOW_PIPELINE_PATH=1 agentflow serve,README 说这个开关只该给运维控制的受信工作流用。
CLI 命令一览:
agentflow run pipeline.py            # 运行管道
agentflow run pipeline.py --output summary
agentflow inspect pipeline.py        # 展开显示图结构
agentflow validate pipeline.py       # 只校验不运行
agentflow evolve <run_id> -n plan    # 从之前的 Codex trace 提炼 tuned agent
agentflow tuned-agents               # 列出本地已注册的 tuned agent
agentflow tuned-agent codex_tuned    # 查看某个 tuned agent
agentflow templates                  # 列出起始模板
agentflow init > pipeline.py         # 生成一个起始模板
agentflow serve                      # 启动本地 Web UI / API(127.0.0.1:8000)
一次真实任务怎么流过这张图
把上面的机制串起来,看一条"对依赖做安全审计"的管道(受 examples/dep_audit.py 启发,示意):
- 一个
codex节点扫描仓库,列出依赖清单。 fanout把每个依赖分给一个codex实例,各自查安全公告和许可证问题——这一步是并行的。merge(size=N)把若干份结果归并成几组。- 一组
codex节点对归并结果做 review。 - 若 review 没通过评审标准,
on_failure把失败的路径送回对应节点重跑,直到success_criteria满足或到max_iterations。 - 最后
synthesis收敛成一份报告。
整条链里,agent 只负责单点判断,并行、重试、汇总全由图的语义完成,不靠手写脚本。
怎么读这些数字
Stars 1,405、Forks 290 说明这是个年轻项目(2026-03 创建,半年多积累),不是航母级框架——虽然仓库自述的野心是"orchestrate thousands of agents"。它更值得看的是两件事:一是它把"并发调度、失败重试、结果归约"这些通用痛点做成了极简原语;二是它连着一条完整的落地链路(容器/KVM 执行、模型路由、云端推理、agent 进化),并且背后有一篇论文在验证"harness 结构本身就能显著改变 agent 找漏洞的能力"。
从这些数字推不出:它在生产环境的稳定性、tuned agent 在真实 bug 上的命中率、大规模扇出时的成本。README 没有给出独立 benchmark,论文里的 84.3% 和 10 个零日是研究场景下的结果,不代表开箱即用的工程数据。要判断它是否适合你,得看你的场景是否真的需要"几十个 agent 并行 + 迭代收敛",而不是看 Star 数。
谁该先试,谁可以等
- 适合先试:已经在用 codex / claude 做多轮代码任务,发现并发和结果汇总靠脚本越写越乱的人;想在一张图里混跑云端强模型和本地便宜模型的人。
- 可以再等等:单 agent 就能跑完的简单任务,用不上这套编排;对 graph 的检查与改写能力(optimizer、evolve)没有迫切需求的话,它的核心价值只剩
fanout+merge,用脚本也能凑合。
从 agentflow init > pipeline.py 起一个模板,跑通 agentflow inspect 和 agentflow validate,再决定要不要把真实任务迁进来。README 里那 13 个示例(从 airflow_like.py 的基础流水线到 cloud_hypervisor_target.py 的 KVM 执行)覆盖了从入门到远程执行的全路径,照着一份份改就能上手。
结语
AgentFlow 的价值不在多了一个调用 agent 的方式,而在于它把"多 agent 协作"从一段不可复用的脚本,变成了可序列化、可检查、可并行、可迭代的图。它把并发、重试、汇总、远程、模型路由这些散落的问题收进同一套原语,让"跑几十个 agent"这件事从工程的边缘事项变成了声明式表达。项目还很年轻,但这条"agent 图 = 可编程数据"的思路,加上九月往类型化组件走的演进,比它当前的 Star 数更值得关注。
参考来源与口径说明
- 仓库元数据(Stars/Forks/推送时间等)为 GitHub API 2026-09-23 拉取值;机制描述对照 master 分支 README、docs/(actors-and-profiles、pipelines、cli)及 agentflow 源码(dsl.py、specs.py、scratchboard.py、worktree.py)逐项核实。
- 论文数字(84.3%、10 个 Chrome 零日、CVE-2026-5280/CVE-2026-6297、作者名单)对照 arXiv 2604.20801 摘要与 README 引用块核实。
- 本文初版数据口径为 2026-08-30;2026-09-13 的 #43 提交(typed actors、agent profiles、Harbor Terminus 2)晚于该口径,已单独成节补入。
- README 一键安装脚本地址写的是
shouc/agentflow,该仓库已不存在;正文按agentenv/agentflow下的实际路径给出,实测可用。ProviderConfig字段以 specs.py 源码为准。
参与讨论
使用 GitHub 登录。欢迎补充事实、异议与实践。
讨论暂时无法加载。